Metriche di valutazione
Quando addestriamo un modello, dobbiamo misurare quanto è bravo. Una metrica è un numero che riassume la qualità delle previsioni.
Nel caso della classificazione, la metrica più comune è l’accuracy, ma non è sempre sufficiente.
Accuracy
L’accuracy indica quante previsioni sono corrette sul totale.
- Se su 100 esempi ne indovino 85 → accuracy = 85%
- È intuitiva e utile quando le classi sono “bilanciate”.
Quando l’accuracy inganna
Esempio: Nella mia casella di posta in una settimana ricevo 100 email. Di queste:
- 95% non sono spam
- 5% sono spam
Se un modello risponde sempre “non spam”:
- accuracy ≈ 95% che può sembrare buona
- ma non riconosce mai lo spam
Quindi un’accuracy alta può nascondere un modello inutile.
Tipi di errore: non tutti gli sbagli pesano uguale
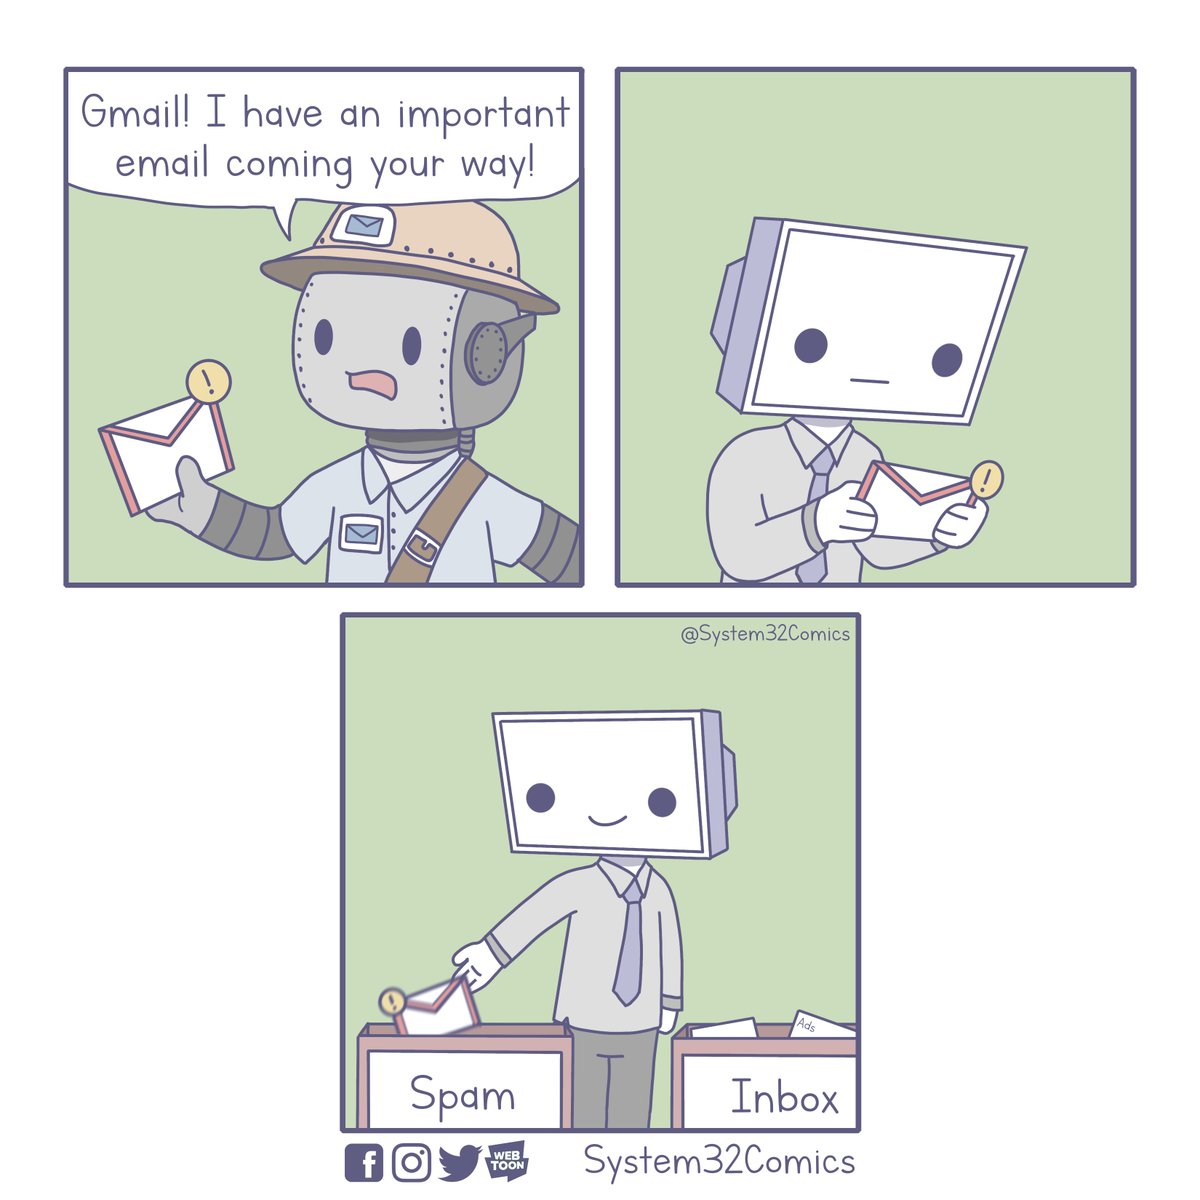
In una classificazione binaria (es. spam / non spam) esistono errori diversi:
- prevedo spam ma era non spam (falso allarme) (falso positivo)
- prevedo non spam ma era spam (mancato rilevamento) (falso negativo)
In contesti reali, uno dei due errori può essere più grave dell’altro.
Confusion Matrix
La confusion matrix è una tabella che conta:
- quante previsioni sono corrette
- e come il modello sbaglia

In questo grafico sono presenti quattro valori importanti:
- Veri Positivi (TP)
- Veri Negativi (TN)
- Falsi Positivi (FP)
- Falsi Negativi (FN)